Зміст
15 вересня компанія TypeSafe AI випустила Jev, модель, яка відповідає готовим значенням замість абзацу тексту, і поставила на головну сторінку 193,6 раза швидше і 444,6 раза дешевше. Ми звірили ці числа з власними сторінками вендора і з замірами, які за перший тиждень опублікували інші люди. Економія справжня, і вимірюється вона разами, не сотнями разів; а те, чого не пишуть на головній сторінці, це що модель ніколи не каже «не знаю».
15 вересня компанія TypeSafe AI випустила модель під назвою Jev. На її головній сторінці великим шрифтом стоять два числа: «193.6x Faster, 444.6x Cheaper», тобто у 193,6 раза швидше і в 444,6 раза дешевше. За кілька днів модель зʼявилась в інструментах, якими користуються ваші розробники, тож цілком імовірно, що слово Jev у вашій команді вже звучало, а слідом за ним і сума, яку це зекономить.
Ця сторінка для людини, яка ухвалює рішення і не пише коду. Нижче: що ця штука робить, що з нею вже працює і що лише показали на відео, скільки вона коштує, звідки взялось число з головної сторінки і чому воно не сходиться, і який ризик жоден вендор на головну сторінку не виносить. Усе тут звірене або з власними сторінками вендора, або із замірами, які опублікували й підписали своїм імʼям інші люди. Коду на цій сторінці немає.
Що ця штука робить
Сьогодні програма надсилає моделі питання і отримує назад абзац тексту. Далі другий шматок коду читає той абзац і витягує з нього одне слово, яке програмі й було потрібне: категорію, згоду, число. Цей другий шматок пише людина, підтримує теж людина, і коли якоїсь ночі модель сформулює відповідь трохи інакше, ламається саме він.
Jev відповідає самим значенням. Приходить сама відповідь: варіант номер три з восьми; оцінка чотири за пʼятибальною шкалою; число від нуля до одиниці. Для вибору і для оцінки поруч з відповіддю приходить число, яке показує, наскільки модель у ній упевнена, і програма вирішує, чи цього досить, щоб діяти. Документація вендора називає три типи питань уже після того, як їх описала: вибір зі списку зветься Choice, оцінка за шкалою зветься Score, число від нуля до одиниці зветься Noul.
Для грошей важливі дві властивості. Усі три типи питань уміщаються в один запит, і документація каже, що додавання питань майже не міняє час відповіді. І писати тексти ця модель не вміє взагалі. Вона не заміна чатботу, і люди самого вендора кажуть це прямо: «It's not really a chat interface, it's meant for consumption by machines», тобто це не чат; відповіді тут читає програма, і для людини вони не призначені.
Що саме зникає
Найзрозуміліший приклад дала служба підтримки, яка викинула зі свого коду цілий список. Її команда тримала вручну написаний список префіксів у темі листа кількома мовами, щоб ловити автовідповіді й спам. У день виходу Jev вони замінили той список трьома питаннями в одному запиті. Розкласти один лист по цих трьох питаннях забирає 639 мілісекунд, менше за секунду, а все разом коштує «about 36 cents a month», близько 36 центів на місяць.
Ось із чого складається виграш, і це варто тримати в голові раніше за будь-яке велике число. Зник шматок коду, який хтось у вашій команді підтримував, а на його місці три речення, написані звичайними словами.
Що вже збудовано: три різні речі під одним словом
За тиждень після виходу показали близько сотні проєктів. Це різні за вагою докази, і саме різниця між ними вирішує, чи стосується вас конкретне число. Ми ділимо їх на три групи і не змішуємо.
**Працює в живому продукті, і зробив це не вендор.** Таких два. Компанія, що продає сховище даних, додала функцію класифікації для своїх платних клієнтів: на ста тисячах новинних заголовків ця функція обробляла 2 484 рядки на секунду з точністю 89% за 50 центів, тоді як модель, яку вона замінила, витратила на ту саму роботу півгодини і $37,58. І служба підтримки вище, яка з першого дня фільтрує справжню пошту.
**Виміряно на справжніх даних, але для клієнтів не вмикали.** Ця група більша і корисніша. Команда, яка оцінює відповіді за шкалою, працюючи в ранньому доступі в день виходу, повідомила про $160 за мільйон оцінок проти $33 000 у великої універсальної моделі, з тих, що відповідають у чатах, причому обидві дійшли однакового вердикту в 91,5% випадків. Команда з безпеки прогнала сто справжніх викликів агента і отримала від 93% до 95% правильних відповідей проти 98% у такої самої великої моделі. Компанія, яка обробляє звіти про витрати, класифікувала дві тисячі звітів за 21 секунду приблизно за пʼять центів і в тому ж дописі написала: «None of this is in production yet, it's just alpha work», тобто нічого з цього ще не ввімкнено для клієнтів, це рання проба. Команда, яка звіряє записи між базами, зрізала вартість моделі на 99,56% і втратила менше пів відсоткового пункту точності.
**Показано на відео, і автори самі це кажуть.** Браузерний агент бронює авіаквиток за 7,1 секунди, і його ж опис каже, що це «three repeats of one task on one browser profile, not a general reliability benchmark», тобто три повтори одного завдання в одному браузері, і це не перевірка надійності взагалі. Дрон проходить смугу перешкод у симуляторі, а його автор пише, що Jev «cannot be the perception layer», він не може бути тим, що бачить світ навколо, і не встигає віддавати команди вчасно. Торговий бот вирішує купувати чи продавати кожні 300 мілісекунд, тричі на секунду проти справжнього списку заявок на біржі, але з вигаданими угодами і без грошей усередині.
Найгучніший приклад тижня прийшов з допису, який переглянули 112 575 разів. Засновник компанії, що продає автоматизовану бухгалтерію, написав: «The bookkeeping services industry is dead… I fed it 34 months of work a firm charged $20,000+ for. Jev did a better job in 20 seconds, for just $0.32». Тридцять чотири місяці роботи, за яку бухгалтерська фірма виставила понад двадцять тисяч доларів, прогнані за двадцять секунд і тридцять два центи.
Поруч із цим числом мають стояти дві речі. Автор продає продукт, який на власному сайті обіцяє «replace QuickBooks plus manual bookkeepers», замінити QuickBooks і бухгалтерів, тож ринок, який він оголосив мертвим, це ринок, з яким він конкурує. І два числа в тому дописі різні за природою. Гонорар фірми покриває рішення, відповідальність, спілкування з податковою і підпис під звітом; модель розклала операції по категоріях. Порівняння, яке щось вам скаже, вимірюється не гонораром фірми. Воно вимірюється тим, скільки те саме розкладання коштує вам сьогодні в інший спосіб.
Практична користь із цього поділу одна: про будь-яке демо, яке вам показують, можна спитати команду, до якої з трьох груп воно належить. Число з третьої групи каже, на що модель здатна в хороший день. Що вона робить у будній день, каже лише перша.
Скільки це коштує
Сторінки з цінами не існує. Обидві адреси, де вона мала б бути, віддають помилку. Уся ціна продукту це чотири рядки в таблиці всередині документації: $42 за мільярд токенів на вході, а токен це шматочок слова, яким модель рахує текст, і відповіді безкоштовні. В одиниці, яку легше втримати в голові: у замірі вище розкласти сто тисяч новинних заголовків коштувало пʼятдесят центів.
Дві речі з тієї сторінки мають прозвучати в будь-якій розмові про бюджет. Ліміти на те, скільки ви можете надсилати, «adjusting dynamically» і «can change without notice», тобто змінюються динамічно і можуть змінитись без попередження. А в дописі про запуск вендор пише: «We can't prove it isn't subsidized», ми не можемо довести, що ціна не субсидована. Це чесне речення, і це ж попередження: ціна, під яку ви плануєте, це ціна, яку продавець не гарантує.
Тепер про ті 444 рази
На головній сторінці написано про 193,6 раза швидше і 444,6 раза дешевше. Одразу під цим та сама сторінка показує демонстрацію, з якої ці числа нібито й узяті: один запит за $0,000081 і 0,114 секунди проти $0,013880 і 8,566 секунди. Поділіть, як поділили ми. Виходить 75 разів швидше і 171 раз дешевше. Власний доказ сторінки не дає того числа, яке на ній написано великим шрифтом.
Допис про запуск обережніший, і треба віддати вендору належне: він сам називає свої слабкі місця. Числа із заголовка, пише він, узяті з чотирьох робочих сценаріїв, і «we expect that these are on the higher end of real world gains», тобто це радше верхня межа виграшу. Правильною відповіддю, за якою всіх оцінювали, був «the average of GPT-6 Astra and Fable 5.1», усереднення відповідей двох конкурентів, і допис визнає, що це «biases answers towards OpenAI and Anthropic's models», тобто перекошує відповіді на користь моделей OpenAI і Anthropic. А самі сценарії «were made by individuals on our model capabilities team, so some bias could exist», їх склали люди з його ж команди.
Власна порівняльна таблиця вендора це найцікавіша сторінка, яку він публікує, бо Jev її не виграє. У Jev точність 67,8%, тобто приблизно кожна третя відповідь хибна. У двох інших моделей 74,1% і 73,1%. З третьою Jev іде врівень, 67,8%. Виграє Jev ціну і час на один випадок, і виграє з великим відривом.
Візьміть із тієї таблиці найближчого до Jev за ціною і швидкістю конкурента з приблизно тією ж точністю і поділіть опубліковані вендором числа. Виходить приблизно у 32 рази швидше і приблизно у 8 разів дешевше. Це ділення наше, на числах вендора.
І є замір, зроблений на власній живій пошті однієї команди. Команда прогнала Jev і свою звичайну модель через власну поштову систему і отримала «Twelve times faster at the median», у дванадцять разів швидше за медіаною, 605 мілісекунд проти 7 326, тобто півсекунди проти семи з половиною секунд. А далі не зупинилась, і саме тому той допис вартий читання: «Divide latency by output tokens and the gap narrows to roughly 3x», поділіть затримку на довжину відповіді, і розрив стискається приблизно до трикратного. Окремим рядком там же: «Per input token the two are 1.31x apart. The whole of the rest is that Jev does not charge for output at all», на одному вхідному токені різниця в 1,31 раза, а вся решта економії це те, що за відповіді поки не беруть грошей.
Чесна версія заголовка така. Дешевше і швидше, рахунок іде на одиниці й десятки разів, чимала частина економії тримається на тому, що відповіді сьогодні безкоштовні, а ще частину виграшу дає сам спосіб питати дрібними питаннями з готовими варіантами.
Модель ніколи не каже «не знаю»
Вендор цього не ховає. Головна сторінка обіцяє «Zero Hallucinations», нуль галюцинацій, тобто нуль вигаданих відповідей. Допис про запуск пояснює, що саме це означає: «Our number is not empirical. Schema matching is guaranteed», цього числа ми не міряли, гарантовано лише те, що відповідь матиме задану форму. Власна довідка компанії каже ще різкіше: модель «can't invent a category outside that list, but it can choose the wrong one», вона не вигадає категорії поза списком, але може обрати неправильну.
Як це виглядає в замірі: незалежна перевірка поклала перед моделлю тридцять повідомлень, що лежали поза темою питання, і вона не позначила жодного, відповідаючи з упевненістю 0,99. Рецепт торта вона віднесла до технічних проблем з упевненістю 0,94, а випадковий набір літер з 0,97. В окремій роботі іншого дослідника серед відповідей, у яких модель була найменш упевнена, 16,6% усе одно виявились небезпечними.
Найгостріше проблему сформулював читач, який публічно сперечався із засновником компанії: «An approve for an unauthorized action still meets the schema guarantee… I still have to define the constraints and test which wrong actions get through the complete workflow on my own data. That's a substantial part of the work being pushed back onto the developer.». Дозвіл на дію, якої робити не можна, теж має правильну форму, і йому все одно доведеться самому визначати обмеження і перевіряти, які хибні дії пройдуть крізь увесь процес на його ж даних. Чимала частина роботи просто переходить на розробника.
Це і є чесний обмін. Код, який витягував відповідь з абзацу, зник. На його місце приходить рішення, за яке тепер відповідає хтось у вашій команді: за якої впевненості ми діємо і хто перевіряє відповіді, у яких упевненість нижча.
Де воно не працює
- Мови, крім англійської. В одному замірі та сама задача дала 14,6% на китайській частині даних проти 57,7% на англійській. Про поведінку на українській не опублікував жодного числа ніхто у світі.
- Довгі документи з багатьма категоріями. Розробник натренував власну маленьку модель на 250 розмічених рядках і обійшов Jev у класифікації тем на 12 відсоткових пунктів, і розрив завеликий, щоб бути випадковістю.
- Усе, що потребує очей. Вона не бачить зображень. У демонстрації з дроном картинку спершу перетворювала на текст інша програма, і автор сам про це пише.
- Чимала частина виграшу належить самому способу питати. У власній таблиці вендора кожна модель стає кращою, коли ту саму задачу розбивають на дрібні питання з готовими варіантами відповіді. Одна маленька модель так іде з 18,1% до 53,6%: була правильна приблизно кожна пʼята відповідь, стала більш ніж половина. Чимала частина того, що продають як перевагу цієї моделі, насправді дає інший спосіб питати, і він працює з будь-якою моделлю.
Хто за цим стоїть і чого ще немає
TypeSafe AI заснована в 2024 році й підняла посівний раунд на $40 мільйонів на чолі з DCVC, і це кажуть як оголошення про раунд, так і сам інвестор. Її власний профіль компанії подає штат від 11 до 50 осіб, працює вона із Сан-Франциско. Список очікування закрився 20 вересня, тож зареєструватись тепер може будь-хто.
Чого немає, то це незалежної перевірки. Компанія прямо каже, що з новими моделями не публікує стандартних порівняльних таблиць, за якими міряють усіх. Наукової статті немає. У звичних незалежних рейтингах моделі немає. Усе вище, що походить не від компанії, опубліковано за останні сім днів, частина компаніями, частина окремими розробниками, і жоден із цих замірів ніхто поки не повторив.
І ще одне, що варто знати, перш ніж читати чийсь огляд. Велика платформна компанія додала Jev до власного продукту і випустила про нього девʼять сторінок за чотири дні. Ми прочитали сім із цих девʼяти, і в жодній немає власного заміру; в одній числа прямо названі вигаданими для прикладу. Це канал продажу пише про те, що продає, і так робити можна. І це ж причина питати про будь-яку захоплену сторінку: хто виграє, якщо ви скажете так.
Що спитати у своєї команди
- Яка з наших задач це вибір зі списку? Якщо відповідь «жодна», розмова на цьому закінчується. Ця модель робить одне: вибирає зі списку, оцінює за шкалою і каже, наскільки впевнена. Усе, що продає компанія, тримається на тому, що у вас є задача такої форми і ви робите її часто.
- Скільки ця задача коштує нам на місяць зараз? Без цієї цифри економію порахувати неможливо. Команда, яка платить сорок доларів на місяць за класифікацію, скорочення на 90% не помітить; команда, яка платить чотири тисячі, помітить.
- За якої впевненості ми діємо і хто це вирішив? Це та робота, яка приходить в обмін на ту, що зникає. Якщо відповісти на це в команді нікому, економію порахували, а нову роботу ні.
- Що станеться з повідомленням, якого наші питання не покривають? Відповідь прийде і виглядатиме впевненою. Спитайте, що команда з цим робитиме, і спитайте до запуску, поки перший інцидент ще не стався.
- До якої з трьох груп належить демо, яке ви мені показуєте? Працює в чиємусь живому продукті; виміряно на справжніх даних, але вимкнено; записано один раз для відео. Ці три важать по-різному, і різниця зазвичай написана в тексті самого автора.
AI-продукти, які ми спроєктували для клієнтів, серед них Sona AI, асистент із чатом, зображеннями, відео й кодом в одному місці, і відгук клієнта на Clutch.
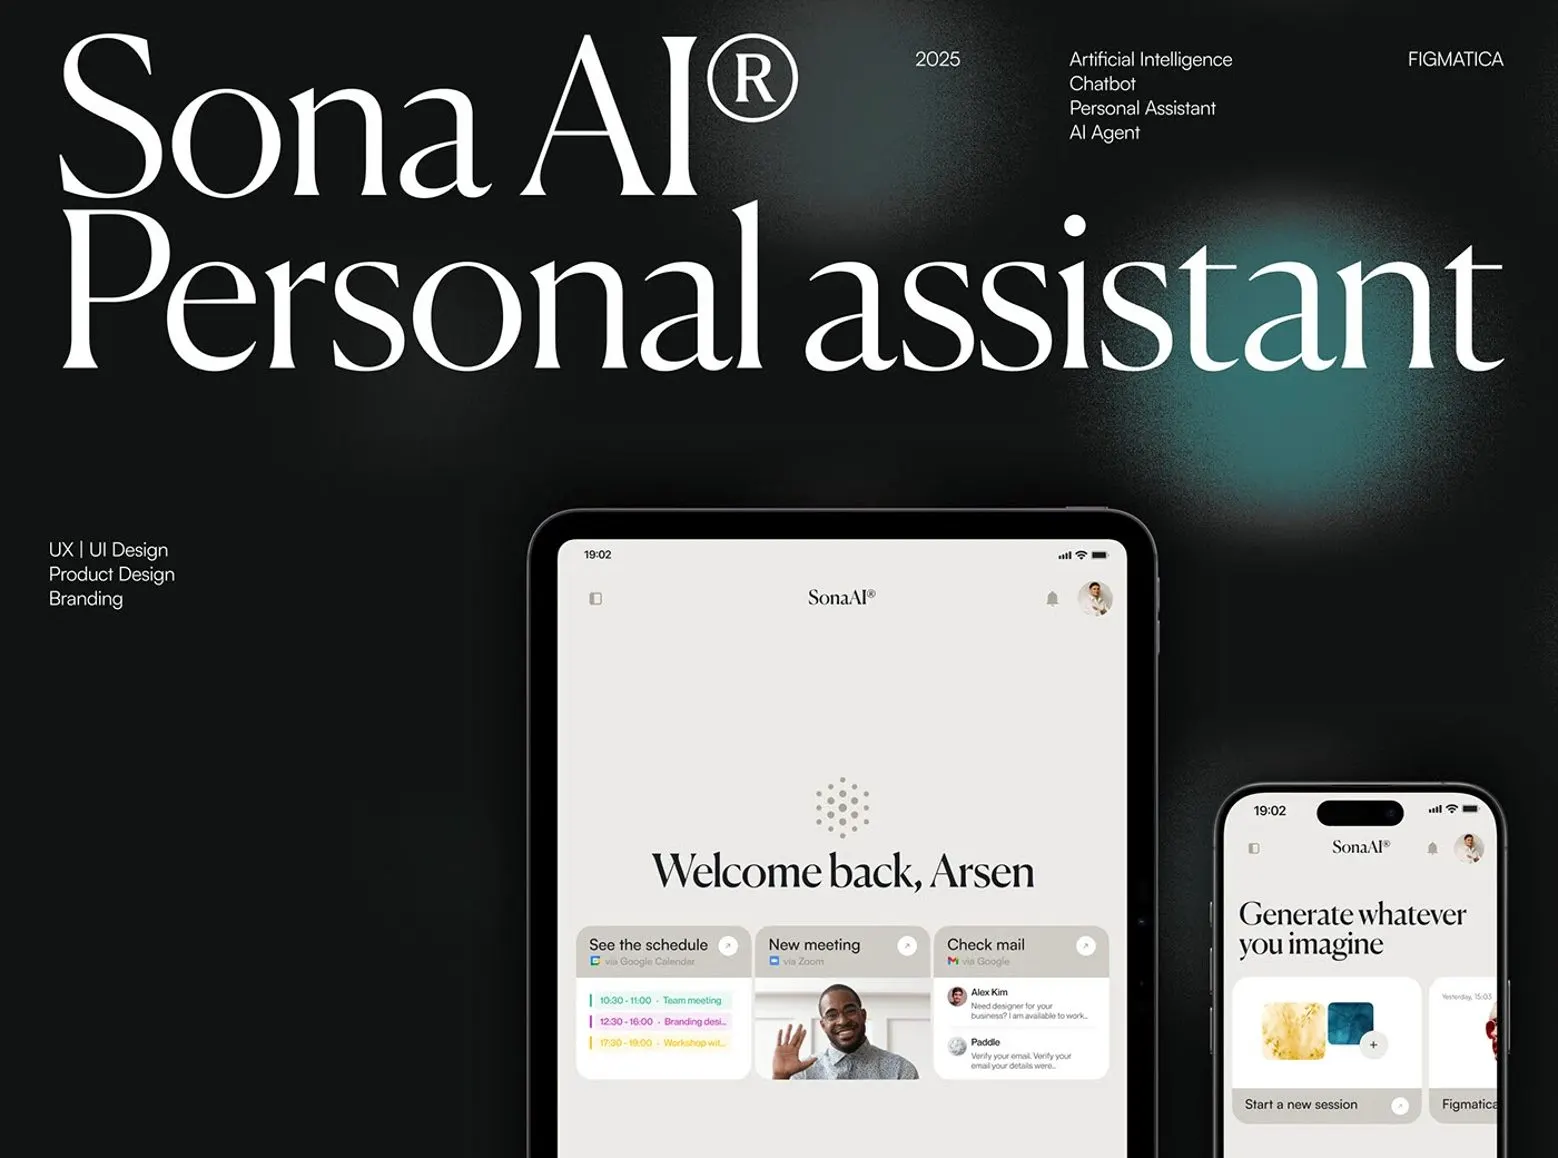 Sona AIAI-асистент: чат, зображення, відео й код в одному місці. Продуктовий дизайн і бренд.
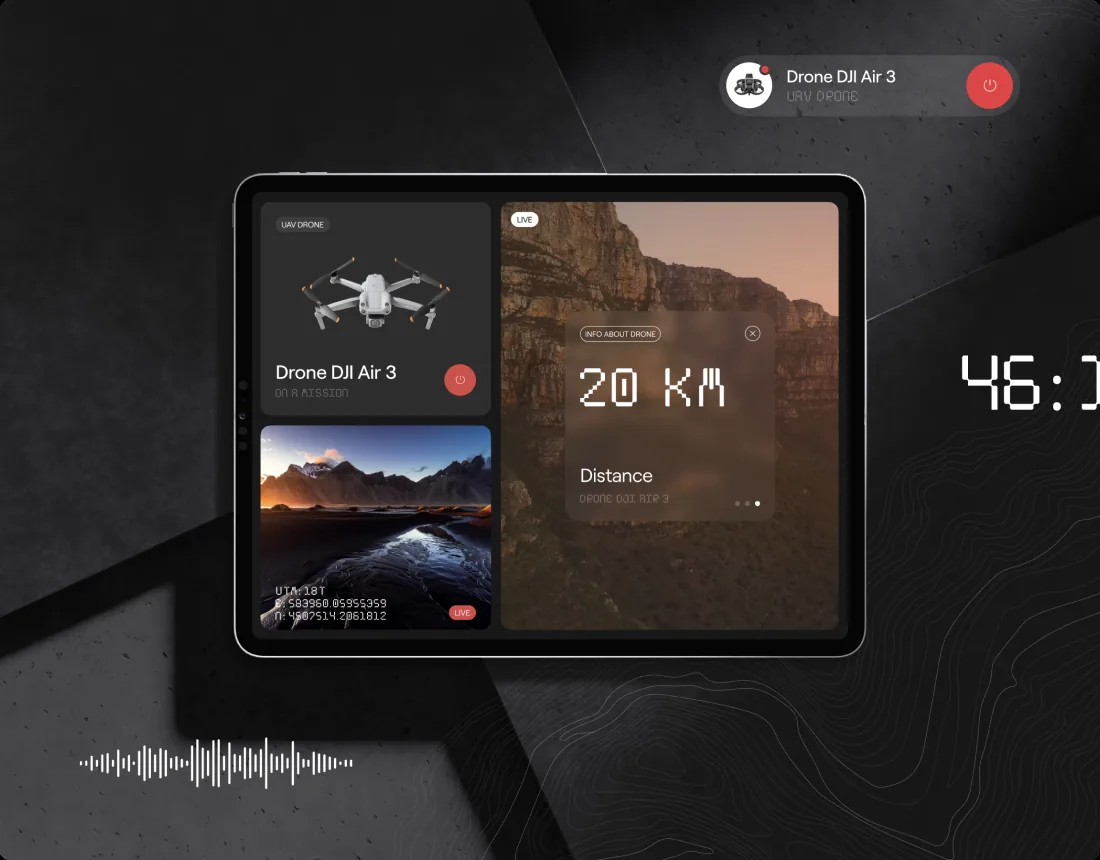 AI Drone ChatBotAI-чатбот для операторів дронів. Продуктовий дизайн у складі виділеної команди стартапу.
«Хлопці зробили більше, ніж обіцяли, і швидко вносили зміни, які ми просили, тож співпраця пройшла гладко.»
 Артем КузьмичCOO · Clutch
Наша позиція
Figmatica будує сайти і програмне забезпечення навколо них, а на нашому власному сайті працює асистент, який робить рівно такий вибір: яку сторінку відкрити відвідувачу, з восьми. Тобто в нас є причина хотіти, щоб Jev працював, і читати цю сторінку варто з цією поправкою. Наше прочитання першого тижня таке: економія справжня, вона менша за обіцяну на головній сторінці, і разом з нею приходить нова робота, якої ніхто не порахував: вирішувати, коли відповідь достатньо впевнена, щоб за нею діяти.
Числа на цій сторінці взяті або з власних сторінок вендора, або із замірів, які опублікували інші, і посилання стоїть при першій появі кожного. Якщо якесь із них хибне або застаріло, напишіть на hello@figmatica.com, і ми перевіримо того ж дня.
Що це означає для вашого сайту
Такі моделі вибирають зі списку, і коли хтось просить асистента порадити студію, магазин чи сервіс, ваш сайт це один із варіантів у цьому списку. Для повної картини, з реальними промптами ваших клієнтів, конкурентами і списком виправлень, є наш аудит видимості в AI.
ГоловнеПеревірте безкоштовно, що ChatGPT, Claude і Perplexity можуть прочитати на вашому сайті: шість перевірок головної сторінки.
Сайти й продукти, які ми запустили
 Acvian30+ сторінок за 60 днів: новий сайт на Webflow для глобального HR-партнера
 BloxFiСайт на Webflow з 80+ сторінками країн: як фінтех-API вийшов на світовий ринок
 CheckMyRate2 місяці від дослідження до запуску: сайт на Webflow для австралійського іпотечного брокера
Хочете так само для свого сайту? 30 хвилин, безкоштовно.
Записатися на дзвінок ↗